 速報
最終更新11月13日(本日)は、30分ごとに更新します
11:40Microsoftが、戻りつつある地域の通信を支えるため、設備の能力を足していると発表した(11時9分・11時28分)
更新の記録(6回)
- 11:40Microsoftが、戻りつつある地域の通信を支えるため、設備の能力を足していると発表した(11時9分・11時28分)
- 11:15Microsoftが、影響を受けた設備の再起動に手応えが出ていると発表した(10時45分)。安定を確かめながら、直しを広げる
- 10:40Microsoftが、暗号化した接続を張る処理があふれてサーバーが止まっていたと明らかにした(10時6分)。時期の合うネットワークの設定変更を元に戻し始めた
- 10:10Microsoftが影響の一覧を見直した(9時45分)。影響はメールとやり取りする機能に絞られ、Teamsのチャットとオンライン会議はおおむね使える。リンクを確かめるSafe Linksが働かないおそれも
- 9:40Microsoft 365全体の次の発表が、9時30分から10時30分に変わった(9時9分の更新)。中身は8時59分のOutlookの発表と同じ
- 9:10初版。Microsoftの8時59分の発表(戻したサーバーも、通信を受けるとまた応答しなくなる)までを入れた
Microsoft 365で世界的な障害。Outlookなど約10時間たっても全面復旧せず、原因は未公表
13日1時17分
アクセスが増えたのではなく、自動の点検に落ちたサーバーが次々に外れ、残りに負荷が集まって止まる悪循環が起きた。最初の引き金は未公表で、攻撃の証拠は出ていない。利用者は入れ直しやパスワードの変更をせず、会社は影響と、守りの道具の記録の抜けを確かめたい。
気になることを5行で答えます
01サイバー攻撃なの?
いまのところ攻撃の証拠はない。Microsoftは、時期の合うネットワークの設定変更を元に戻し始めた
02誰が影響を受けている?
Microsoft 365を使う世界の利用者。メールと、メールにつながる機能(予定表・Copilotなど)。Teamsのチャットと会議はおおむね使える
03自分で何かすべき?
入れ直しもパスワードの変更も要らない。急ぎはTeamsのチャットか電話で。メールのリンクは、いつもより慎重に
04会社は何をすべき?
影響と失敗した仕事を記録し、復旧後に守りの道具(Defender XDR・Purview)の記録の抜けを確かめる(詳しく)
05いつ直る?
未定。戻りつつある地域があり、設備の能力を足して支えている。次の発表は12時と12時30分
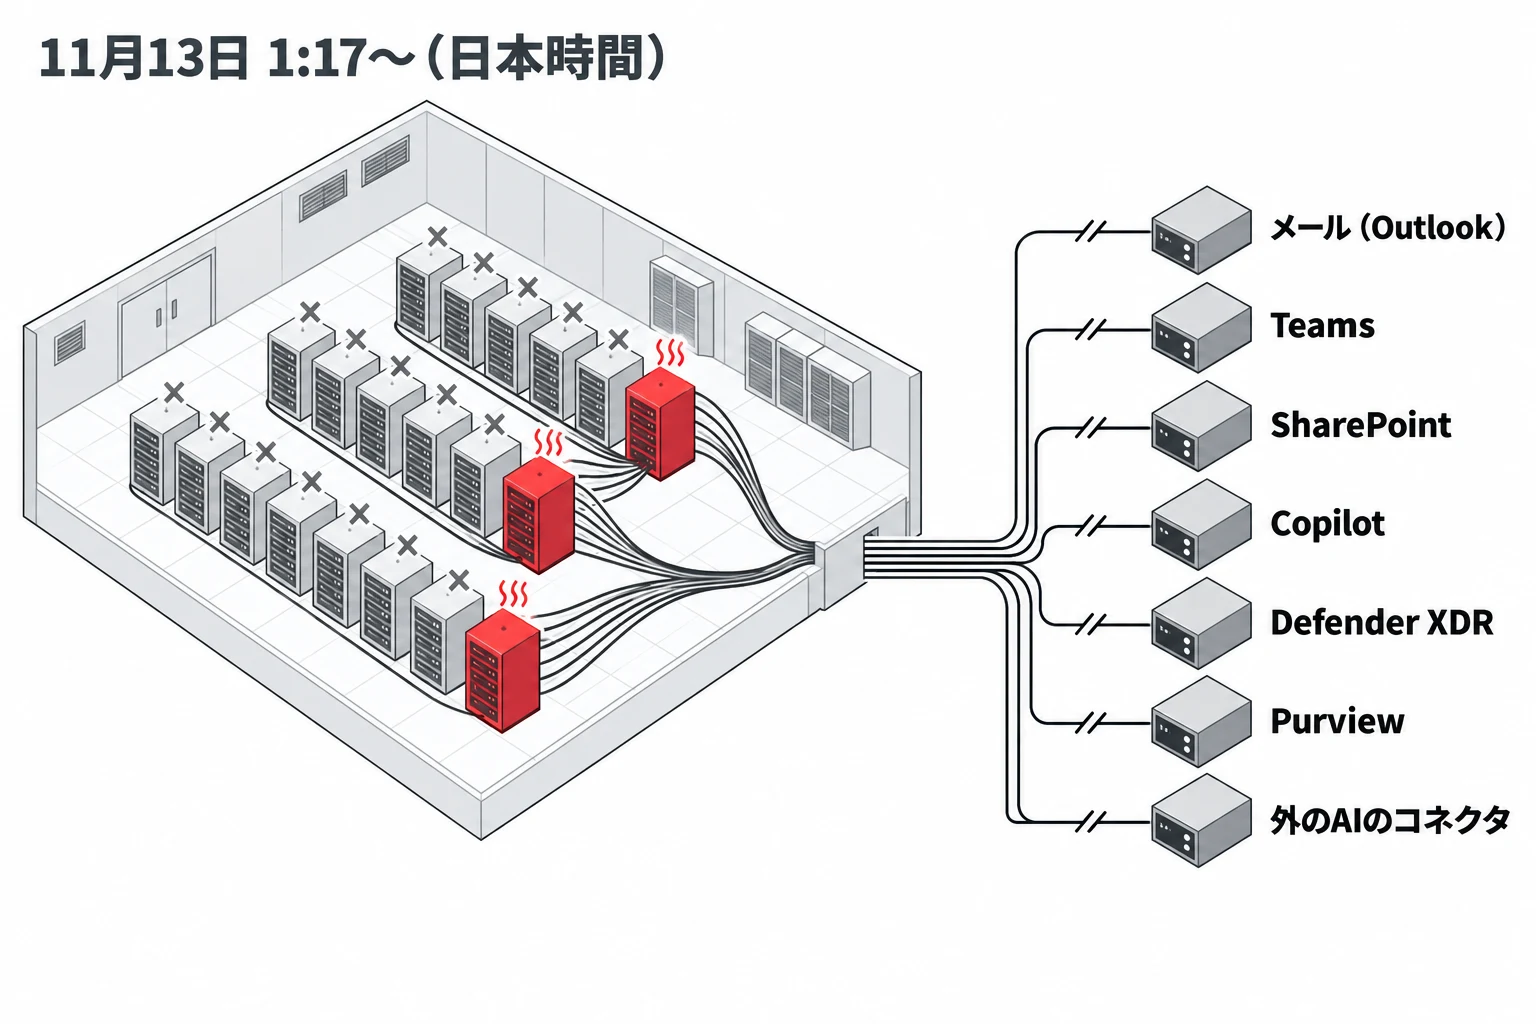
2026年11月13日の未明(日本時間)、MicrosoftのクラウドサービスMicrosoft 365で、大規模な障害が起きた。メールのOutlookから始まり、会議のTeams、ファイルのSharePoint、AIのCopilot、攻撃を見張るDefender XDR、情報漏えいを防ぐPurview、さらにChatGPTやClaudeからMicrosoft 365につなぐ機能にまで影響が及んだ。
11月13日午前11時40分の時点で、全面的な復旧と、最初の原因の発表はない。【11時40分 更新】 Microsoftは11時9分、戻りつつある地域の通信を支えるため、設備の能力を足していると発表した。【11時15分 更新】 Microsoftは10時45分、影響を受けた設備の再起動に手応えが出ていると発表し、安定を確かめながら直しを広げている。【10時40分 更新】 Microsoftは10時6分、サーバーが止まる仕組みが、暗号化した安全な接続を張る処理のあふれだと明らかにし、障害の始まりと時期の合うネットワークの設定変更を元に戻し始めた。Microsoftは8時59分、一度戻したサーバーも、通信を受け始めるとまた応答しなくなると報告した。【10時10分 更新】 9時45分には影響の一覧を見直し、影響を受けるのはメールとやり取りする機能で、Teamsのチャットとオンライン会議はおおむね使えると改めた。次の発表は、12時(Microsoft 365全体)と12時30分(Outlook)の予定だ。この速報では、いま何をすればよいか、なぜここまで広がったのかを、Microsoftの障害の記録と報道から整理する。
01利用者は入れ直し不要。状態を確かめ、急ぎの連絡は別の道で
まず押さえたいのは、これがMicrosoftの側の障害だということだ。自分のパソコンやアカウントの不具合ではないので、Outlookを入れ直したり、パスワードを変えたりしても直らない。
- 状態を見る:Microsoftの稼働状況のページ(status.cloud.microsoft)で見る。自社への影響は、Microsoft 365の管理センター(admin.microsoft.com)の「正常性」→「サービス正常性」で見られる。見るには管理者の役割が要る。誰が管理者か分からなければ、契約しているIT業者に聞く
- 急ぎの連絡を切り替える:【10時10分 更新】 Microsoftによると、Teamsのチャットとオンライン会議はおおむね使える。急ぎはTeamsのチャットか電話で。障害のあいだに送ったメールは、届くのが遅れることがあるので、復旧のあとで相手に届いたかを確かめる
- メールのリンクは、いつもより慎重に:【10時10分 更新】 メールやTeamsのリンクを開く前に安全かを確かめる機能(Defender for Office 365のSafe Links)が、働かないおそれがある
- 便乗した連絡に乗らない:「障害のため、もう一度ログインしてください」といったメールやメッセージのリンクは開かない。大きな障害のときは、それに便乗したなりすましに気をつけたい
02日本でも4時すぎから報告が急増。メール・会議・ファイル・守りの道具に影響
Microsoftの記録では、障害が始まったのは日本時間の11月13日1時17分(米国東部時間の12日11時17分)。最初はOutlookのメールボックスにつながらない障害だった。約2時間後の3時26分、Microsoftはこれを「Microsoft 365全体の障害」として記録し直した。
【10時10分 更新】 Microsoftは9時45分、影響の一覧を見直した。影響を受けるのは、各サービスのうちメール(Exchange Online)とやり取りする機能で、それ以外は動いているという。見直したあとの一覧は次のとおりだ。
| 分野 | サービスと、報告された影響(9時45分の見直し) |
|---|---|
| メール・予定表 | Outlook(Exchange Online):Web版・パソコンのアプリ・スマートフォン・ほかのシステムからメールボックスにつながらないおそれ。メールの配達が遅れることも |
| 会議・連絡 | Teams:予定表や会議の予約など、メールに頼る機能が失敗するおそれ。チャットとオンライン会議はおおむね使える |
| ファイル | SharePoint:メールに頼る機能。SharePointに直接置いたファイルは開ける |
| AI | Microsoft 365 Copilot:チャットが開かない・答えが返らない、メール・予定表・ファイルを使えないおそれ |
| リンクの確認 | Defender for Office 365:Safe Linksがリンクを確かめられないおそれ(OutlookとTeamsのリンク) |
| 攻撃の見張り | Defender XDR:ポータルの画面の一部が開かないおそれ |
| 情報の保護 | Purview:権限の管理、自動のラベル付け、情報漏えいの防止(DLP)、データの分類。ポータルの画面も開かないおそれ |
| ほかのシステムとの接続 | Microsoft Graph:メール・予定表・連絡先を扱う要求が時間切れになるおそれ |
| 仕事の管理 | Planner・To Do:操作の失敗、アプリが開かないおそれ |
| 教育 | Microsoft 365 Education:課題(Assignments)などの機能 |
| 管理 | Microsoft 365の管理センター:一部のページが開かないおそれ。Apps の管理センター:更新・ポリシー・一覧の機能 |
| そのほか | Intune、Power BI・Fabric(機密のラベル付きの報告の書き出し)、Universal Print(印刷)、Windows 365(一部の設定のクラウドPC)、最近使ったファイルの一覧 |
別の管理番号(PP1550869)では、Microsoft Graph(Microsoft 365のデータに、ほかのシステムからつなぐ窓口)を使うPower Platformのアプリやコネクタが、ときどき失敗すると報告された。同じ原因かどうかは、確かめられていない。
日本でも影響が出た。日経によると、障害の報告サイトDowndetectorへの日本の利用者の報告は4時すぎから急に増え、Outlookは6時ごろまでに300件を超えた。SNSには「会社のメールが読めない」という声が上がった(朝日新聞)。日本で何社・何人に影響したかは、まだ分かっていない。
海外では、より大きく広がった。Reutersによると、米国でのOutlookの報告は東部時間の14時7分の時点で9万7,000件を超え、APは13時過ぎに13万件近くに達したと伝えた。カナダ・トロントの病院グループは、メールが使えないため、設備の故障を知らせる「コード・グレー」を宣言した(患者のケアに影響はないと説明)。オーストラリアでは、遠隔教育の学校でTeamsの授業に入れない生徒が出た。これらの件数は利用者が投稿した数で、困った人の数ではない。
Microsoftは最初、南北アメリカの利用者の障害として知らせたが、その後、どの地域の利用者にも影響し得ると改めた。なお、同じMicrosoftのクラウドでも、Azureの稼働状況のページには全体の障害は出ていない。Azure全体が止まったわけではない。
03原因はアクセスの急増ではなく、サーバーの急減。点検に落ちて次々に外れた
これだけ大きな障害だと、「アクセスが殺到したのか」「攻撃か」と考えたくなる。だがMicrosoftは4時18分の更新で、全体のアクセスが増えたのではなく、多くのサーバーが急に使えなくなり、残ったサーバーに負荷が集中していると説明した。
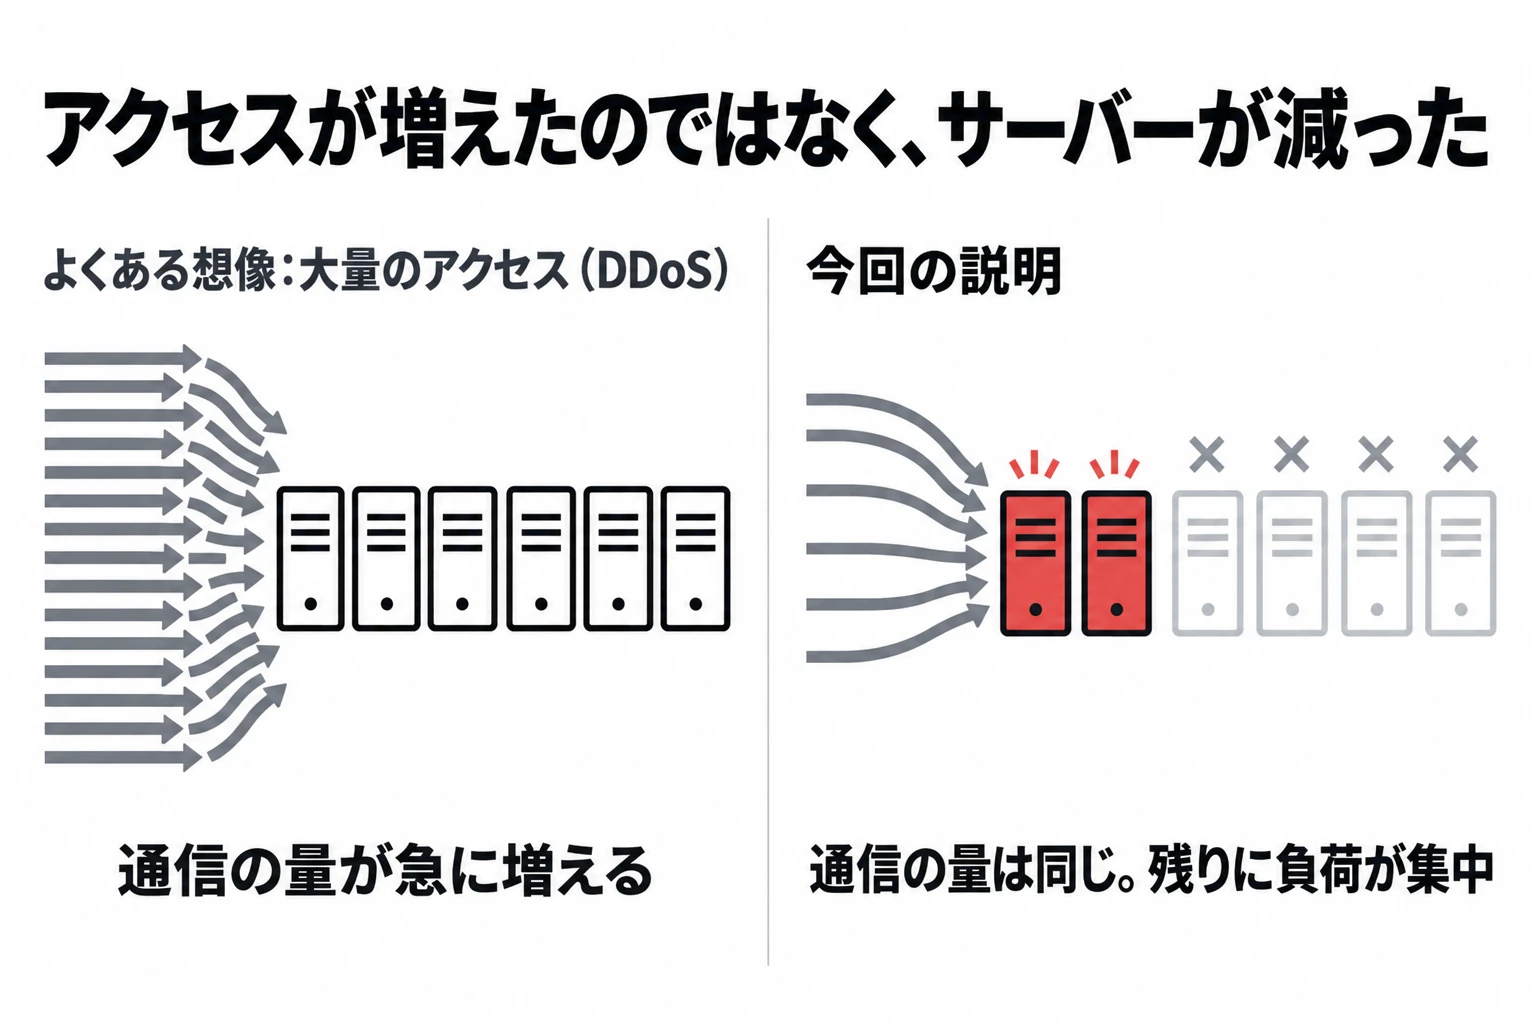
サーバーが外れたのは、自動の点検(ヘルスチェック)に落ちたためだ。クラウドでは、調子の悪いサーバーを点検で見つけ、仕事の割り当てから自動で外す。ふだんは、壊れたサーバーに仕事を回さないための大事な仕組みだ。
スーパーのレジにたとえると分かりやすい。点検で「調子が悪い」とされたレジが次々に閉まると、客は残りのレジに並ぶ。残りのレジは行列をさばききれずに止まり、それも点検で閉められる。開いているレジが減るほど、残りに客が集まる。今回、Microsoftのサーバーで起きたのは、これと同じ悪循環だ。
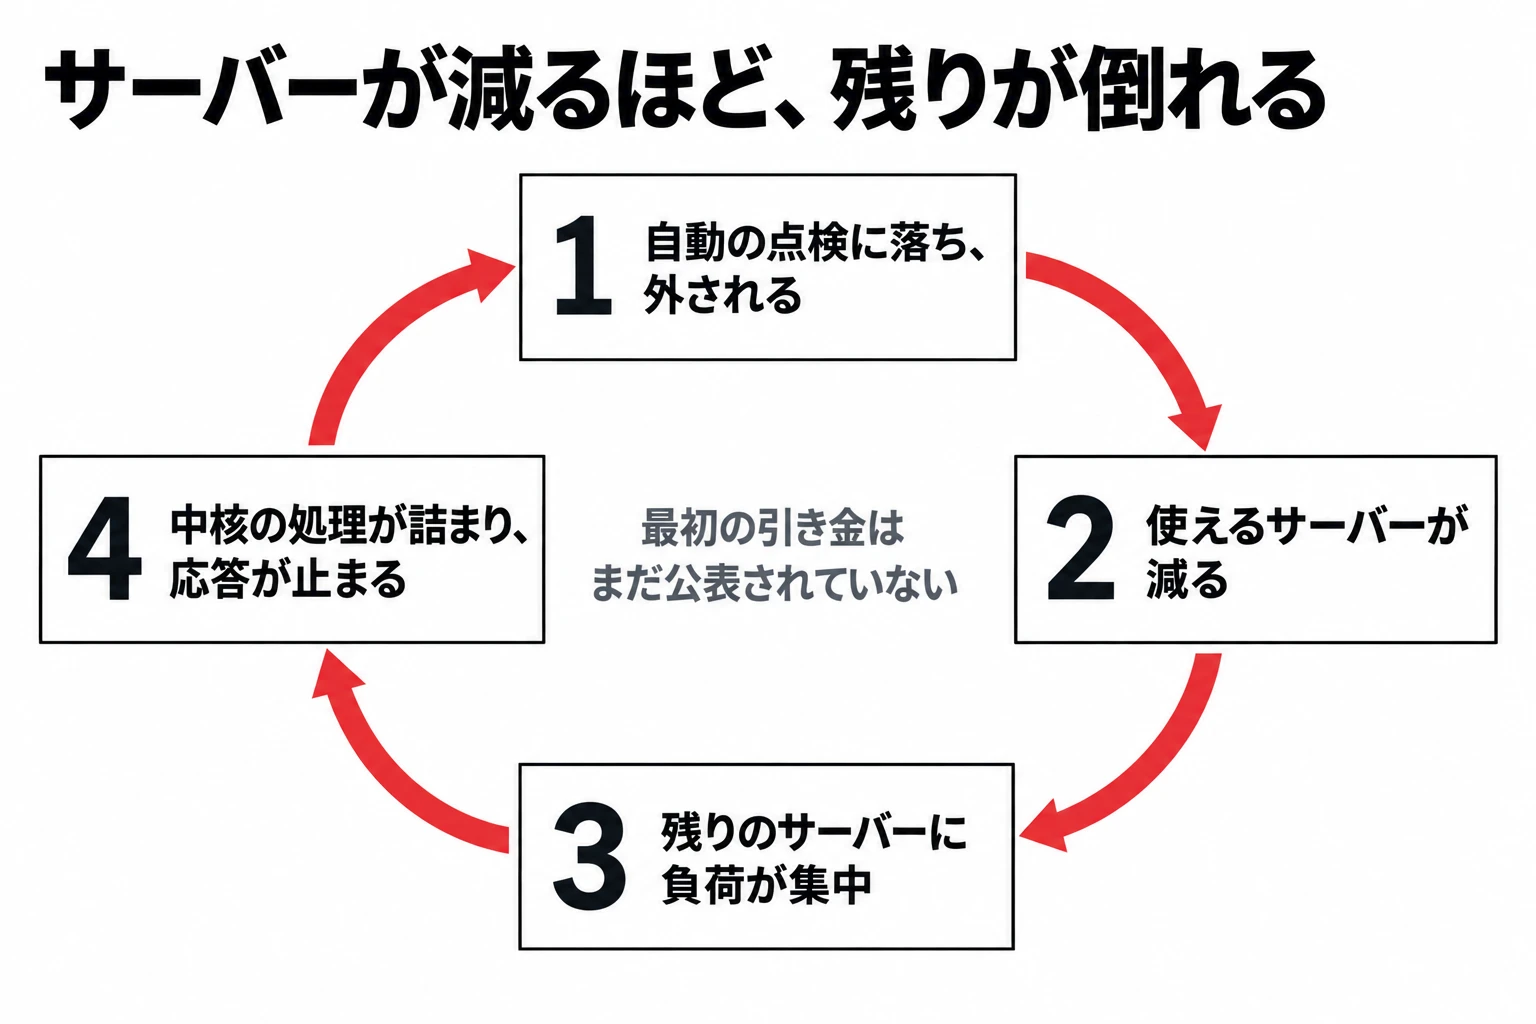
この連鎖は、クラウドの運用ではよく知られている。Googleが公開している運用の手引き(SREの本)は、一つの所が落ちると負荷がほかに移り、そこもあふれて落ちる連鎖を「カスケード障害」と呼ぶ。そして、点検で調子の悪いサーバーを外す仕組みが、かえって回復を妨げることがあると注意している。
【10時40分 更新】 Microsoftは10時6分、影響を受けたサーバーで、暗号化した安全な接続を張る処理(利用者の端末とサーバーが、盗み見されない通信を始めるための処理)があふれ、サーバーが要求を処理できなくなっていたと明らかにした。それを直す設定の変更を一部のサーバーで試してから広げるという。あわせて、障害の始まりと時期の合う最近のネットワークの設定変更を、元に戻し始めた。ただし、Microsoftはこの変更を「時期が合う」としているだけで、原因だとはまだ言っていない。
ただし、今回はまだ分からないことがある。点検に落ちたからサーバーが止まったのか、先にサーバーの処理がおかしくなったから点検に落ちたのか、だ。点検が元気なサーバーを誤って外していたのかもしれないし、本当に動けないサーバーを正しく見つけていたのかもしれない。いちばん初めに何が起きたのかは、まだ公表されていない。
04Microsoftは4時18分に見立てを改め、7時3分に復旧のやり方を変えた
Microsoftの対応は、通信の振り分け、変更の停止、点検の仕組みの見直しと進み、7時3分に、設備の一部を切り離して少しずつ戻すやり方へ替わった。7時58分に一部の地域で限られた回復が報告されたが、8時59分には、戻したサーバーがまた応答しなくなると報告された。下の時系列は、画面に入ると、間の長さを実際の時間に比べて、1時17分から順に出来事が現れる。
1:17
Outlook(Exchange Online)の障害が始まる
メールボックスにつながらなくなる。Web版、パソコンのアプリ、スマートフォンのメール、ほかのシステムからの接続が対象。直前の11月12日23時45分から13日0時53分まで、Teamsで別の障害があった(暫定の原因はリソースの取り合い。今回との関係は確かめられていない)
2:45
接続を受け付ける仕組みの一部で、エラーを確認
通信の記録を集めて、原因を調べ始める
3:19
特定の地域に限らず、負荷が上がる
サーバーの再起動や、別の設備への振り分けを検討する
3:26
Microsoft 365全体の障害として記録する
Teams・SharePoint・Copilot・Defender XDRへの影響を認める(管理番号MO1550821)
3:43
サーバーが断続的に外れ、残りに負荷が集まる
Outlookの接続を、世界各地の設備へ振り分け直す
4:06
新しい配備と設定の変更を止める
障害を広げず、原因の候補を絞るため
4:18
「アクセスが増えたのではない」と見立てを改める
多くのサーバーが急に使えなくなり、残ったサーバーに負荷が集中していると説明
4:43
自動の点検に落ちて外されていると突き止める
関わる部品の設定を変え、再起動して確かめる
4:58
点検の仕組みそのものを疑う
時期の合う変更はまだ見つからないとして、一部で点検を迂回する変更を試す。CPUの使用率が跳ね上がる理由も調べる
5:38
多くのサーバーが応答しない
直し方を試そうにも、相手のサーバーが応答しない。再起動しながら進める
5:56
別のやり方の点検で、一部のサーバーが戻る
対策を広げ、応答しなくなったサーバーを自動で再起動する仕組みを用意する
6:31
最近の少数の設定変更を、元に戻すことを検討
7:03
復旧のやり方を替える
それまでの対策は期待した効果が出ていないと報告。サーバーの中核の処理があふれて応答が止まることが分かった。設備の一部を完全に切り離し、再起動してから少しずつ通信を戻す。地域ごとに切り離す案も検討する
7:58
一部の地域で、限られた回復
一部のサーバーが戻り、いまは安定していると報告。通信を別の道へ移し、1か所で流れる量の調整を試している。利用者の端末がつながり直すにつれ、少しずつ戻る見込み。原因は未確定
8:59
戻したサーバーも、通信を受けるとまた応答しなくなる
原因を調べながら、一部の場所で、届く通信の種類を絞る。特定の種類の要求が関わっていないかを確かめるため。一部のサーバーは、前のソフトウェアの構成で作り直して試す。次の更新は10時
9:45
影響の一覧を見直す。メールとやり取りする機能に絞られる
メール(Exchange Online)とやり取りする機能が影響を受け、それ以外は動いていると説明。Teamsのチャットとオンライン会議はおおむね使え、SharePointに置いたファイルも開ける。一方、リンクの安全を確かめるSafe Linksが働かないおそれがある。最初の原因はまだ調べている
10:06
止まる仕組みが分かる。暗号化した接続を張る処理があふれていた
影響を受けたサーバーで、暗号化した安全な接続を張る処理があふれ、要求を処理できなくなっていた。直す設定の変更を一部のサーバーで試してから、再起動と合わせて広げる。あわせて、障害の始まりと時期の合う最近のネットワークの設定変更を、元に戻し始めた。次の発表は11時(Outlook)と11時30分(全体)
10:45
再起動に手応え。安定を確かめながら広げる
影響を受けた設備の再起動で、よい結果が出ていると報告。戻したサーバーが安定しているかを見ながら、直しを広げていく。全面的な復旧の発表ではない。次の発表は11時30分(全体)と12時(Outlook)
11:09
戻りつつある地域を支えるため、設備の能力を足す11時40分の更新
戻りつつある地域の通信を支えるため、できる所から設備の能力を足していると報告。結果を見ながら、すべての地域を良くする手を探している。全面的な復旧の発表ではない。次の発表は12時(全体)と12時30分(Outlook)
赤い印は、流れの変わり目だ。3時26分に障害がMicrosoft 365全体に広がり、4時18分に「アクセスが増えた」説を退け、7時3分に、それまでの対策が効いていないとして復旧のやり方そのものを替えた。7時58分に回復の兆しが出たものの、8時59分には、戻したサーバーも通信を受けるとまた応答しなくなると分かり、前のソフトウェアの構成でサーバーを作り直す試みに入った。
05攻撃の見張りの道具と、ChatGPT・Claudeのつなぎ先にも影響
今回の障害が重いのは、メールが使えないことだけではない。同じ基盤の上にある業務のサービス、守りの道具、さらにMicrosoftの外のAIまで、仕事を終えにくくなった。下の図は拡大・縮小でき、図の下の番号のボタンを押すと、その場所が赤く光って大きくなる。「順に見る」を押すと、5つの段が順に動く。
外のAIにも影響が出た。OpenAIは、ChatGPTのMicrosoft 365コネクタで、新しい接続やツールの実行に問題があると報告した。Anthropicも、ClaudeのMicrosoft 365コネクタでメール・予定表・検索の多くが失敗し、Claude for Outlookにも影響があるとして、原因はMicrosoft 365の障害だと明記した。
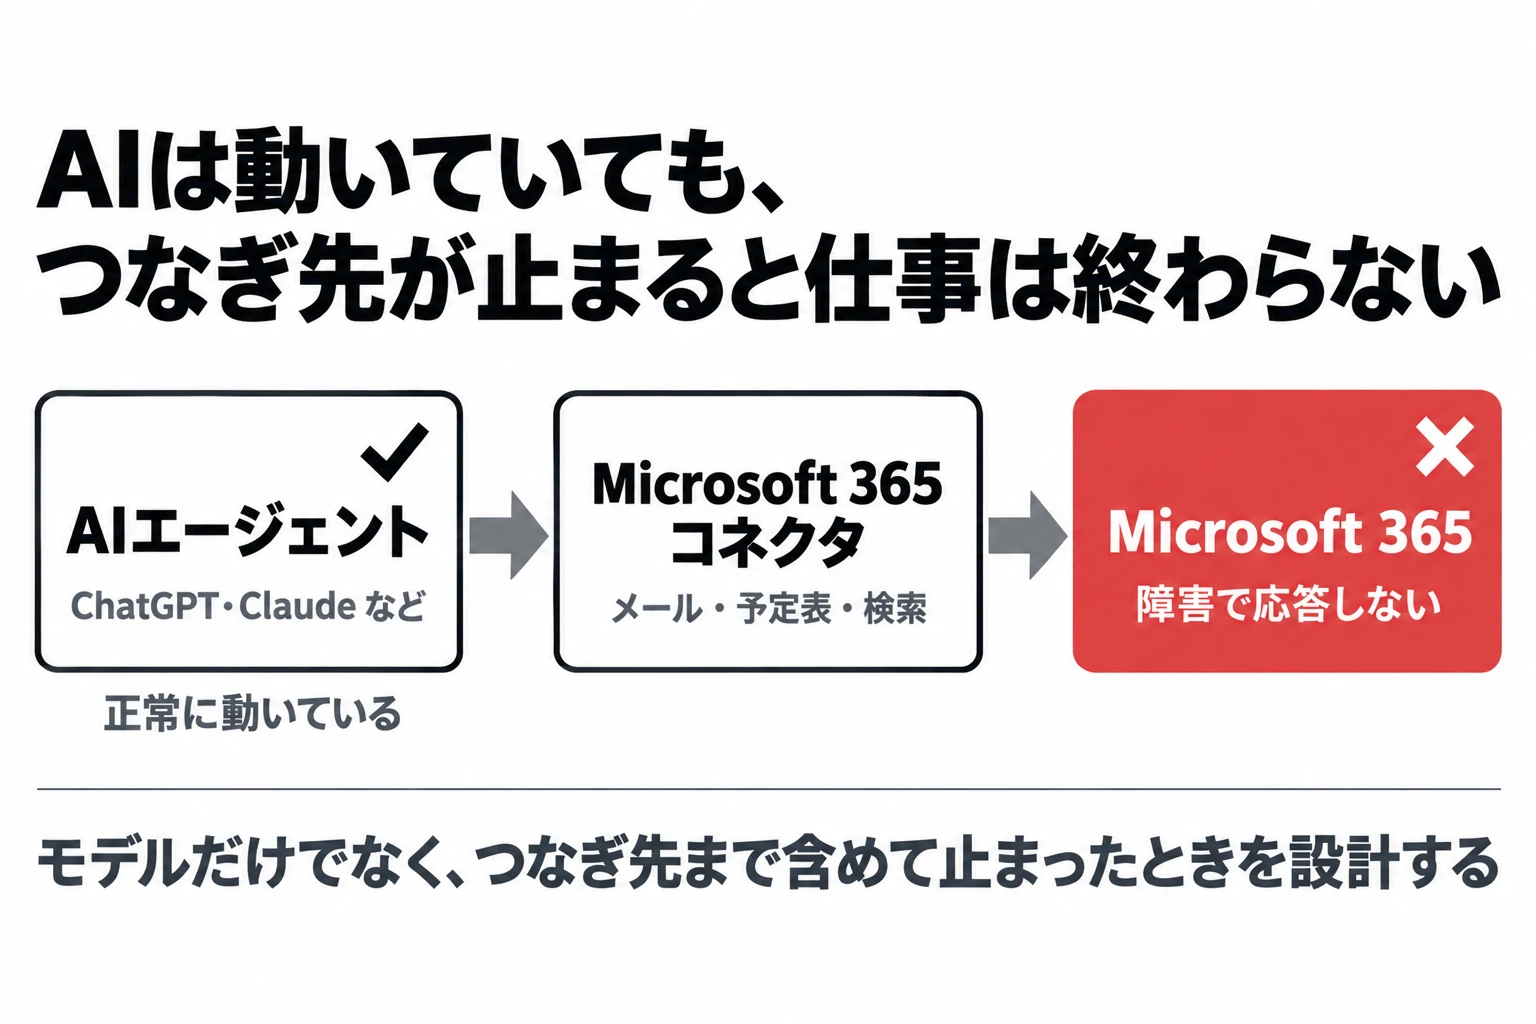
止まったのはAIそのものではなく、AIがつなぐ先だ。AIエージェントがどれほど正常でも、メールやファイルの置き場が応答しなければ、仕事は終わらない。AIエージェントを仕事に組み込むなら、AIが動くかどうかだけでなく、つなぎ先と、その認証やデータの通り道まで含めて、止まったときにどうするかを決めておく必要がある。
【10時10分 更新】 9時45分の見直しでは、メールやTeamsのリンクを開く前に安全かを確かめるSafe Links(Defender for Office 365)が、リンクを確かめられないおそれがあるとされた。障害のあいだは、届いたリンクを開く前に、いつもより注意したい。
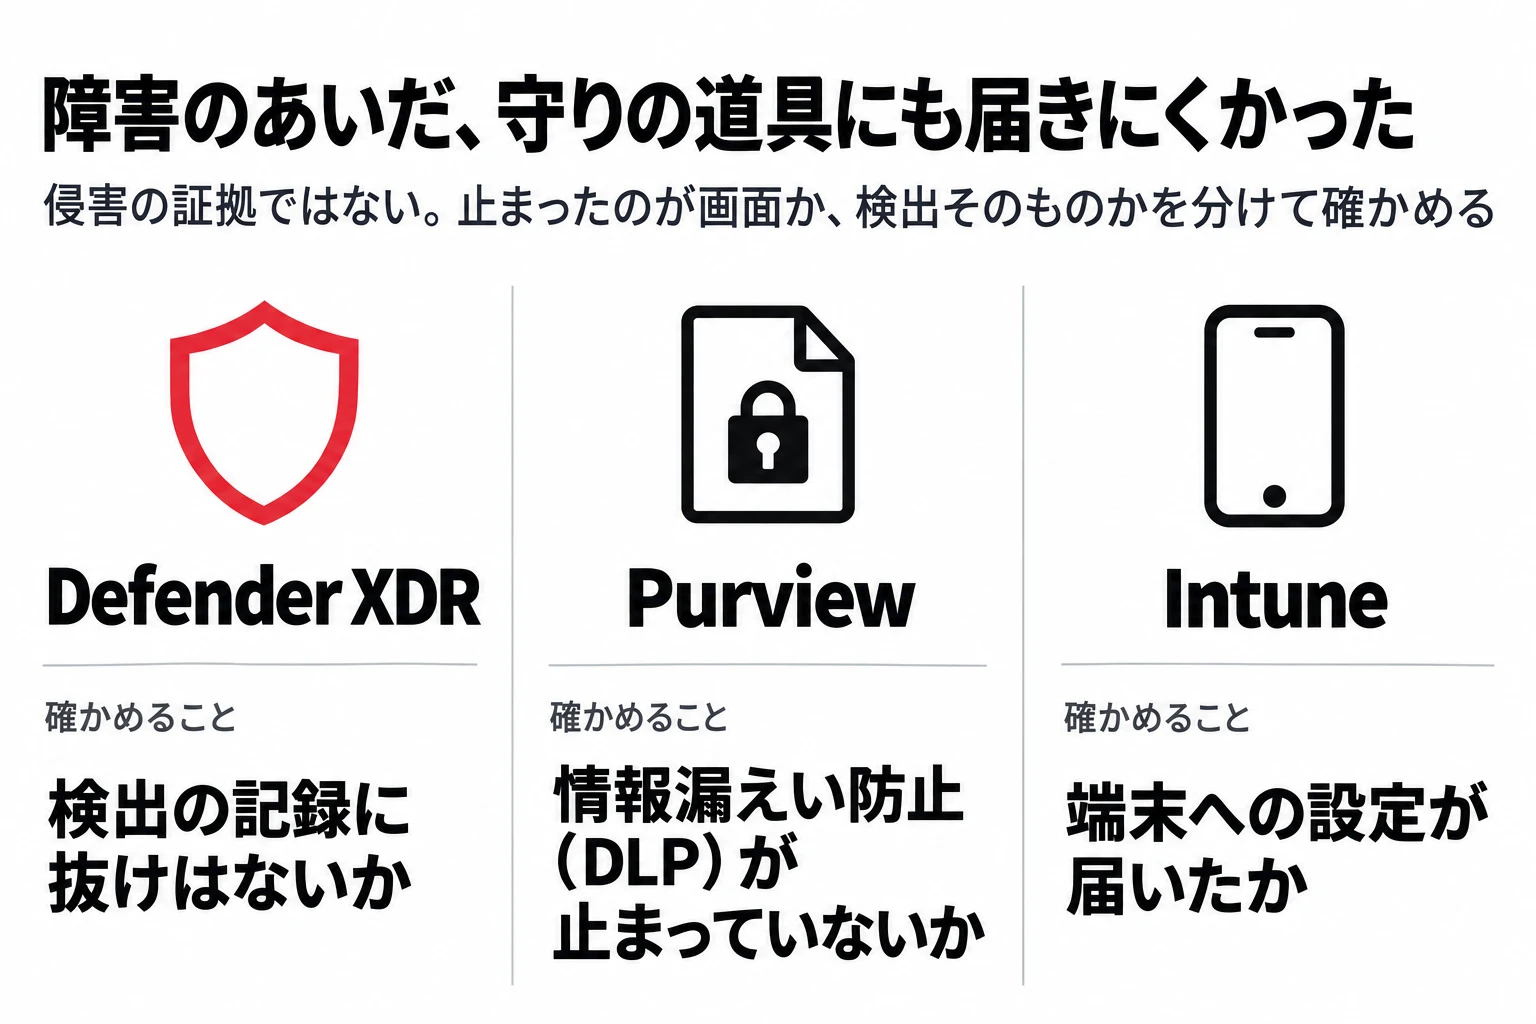
守りの道具に届きにくかったことにも、目を向けたい。Defender XDRやPurviewが影響を受けたのは、攻撃を受けた証拠ではない。ただ、障害のあいだ、見張りの画面や情報漏えいの防止、管理の操作が使えなかった会社では、守りに一時的な空白があったかもしれない。
06攻撃の証拠は出ていない。設定の誤りや不具合が有力な調べの対象
結論から言うと、いま公開されている情報に、攻撃が原因だという証拠はない。米国のセキュリティの専門メディアSecurityWeekも、攻撃の証拠は示されていないと伝えている。ただし、最初の原因がまだ分からない以上、攻撃の可能性が消えたわけでもない。
| 考えられること | いま分かっていることとの合い方 | 見立て |
|---|---|---|
| 大量のアクセスで押し流す攻撃(DDoS) | Microsoftは、全体のアクセスが増えたのが原因ではないと説明している | 裏付けがない |
| 特定の重い処理を狙って、資源を使い切らせる攻撃 | CPUの高騰や応答の停止とは、技術的には矛盾しない | 確かめられていない |
| 侵入して設定を書き換えた | 設定の変更は調べられているが、不正な操作の報告はない | 証拠がない |
| ソフトウェアの不具合・設定の誤り | 最近の設定変更を調べていること、一部の回避策が効いたことと合う。10時6分、時期の合うネットワークの設定変更を元に戻し始めた | 有力な候補だが、確定していない |
| 点検とサーバーの負荷の連鎖 | 負荷の集中と、中核の処理のあふれをMicrosoftが説明している | 広がり方の説明としては合う。何が先かは未確定 |
注意したいのは、特定の重い処理だけを狙う攻撃なら、全体のアクセスは大きく増えないこともある点だ。Microsoftは8時59分の更新で、特定の種類の要求が障害に関わっていないかを、通信の種類を絞って確かめているとした。攻撃とは書いておらず、ソフトウェアの不具合でも同じ確かめ方をする。それでも、「アクセスが増えていない=攻撃ではない」とまでは言えない。
07点検が障害を広げた例は、AWSやAzureでも起きている
点検の仕組みや設定の変更が連鎖のきっかけになった大きな障害は、Microsoftのほかのクラウドでも、ほかの会社のクラウドでも起きている。
| いつ | どこで | 何が起きたか |
|---|---|---|
| 2025年10月 | AWS(米国東部の地域) | データベースの名前の引き当ての不具合が起点。負荷分散の点検が、正常なサーバーを外したり戻したりを繰り返し、自動の切り替えで能力が失われて連鎖した。約14時間半。自動の切り替えを止めて収まった |
| 2026年1月 | Microsoft 365(北米) | 基盤の一部が処理を止め、早く戻そうとした負荷分散の設定変更で、かえって偏りが大きくなった。約10時間 |
| 2026年9月 | Azure(スウェーデン) | 配備で一時的な保存が消え、裏の仕組みへの要求が約20倍に。点検が、再起動を繰り返すループを起こした |
AWSが公開している設計の手引きは、点検を厳しくしすぎると、全部のサーバーが一斉に外れ、小さな不具合が全面的な停止に変わることがあると注意している。今回も同じ仕組みだったかどうかは、Microsoftの原因の報告を待つ必要がある。
08会社がすることは、今日・復旧のあと・ふだんの3段
Microsoftの側の障害なので、会社が今日できることの多くは、復旧のあとに困らないための記録だ。
今日のうちに
- Microsoft 365の管理センターで、自社の環境(テナント)に実際にどんな影響が出ているかを見る
- 障害のあいだに失敗したメール・Teams・SharePointの仕事と、障害のあいだに変えた設定や仮の対策を記録する
- Microsoftの製品のほかに、急ぎの連絡の手段を決めて社内に知らせる
復旧のあとに
- Defender XDRとPurviewの記録、情報漏えいの防止(DLP)の処理、検出の履歴に、抜けがないかを確かめる。止まったのが管理の画面だけか、見張りや検出そのものかを分ける
- 遅れた処理、二重になった処理、送られなかったデータを突き合わせる
- AIエージェントや自動の処理をやり直すときは、同じメールを二度送る、同じ更新を二度かけるといったことが起きないようにする
社員に流す案内は、たとえば次のようにする。
Microsoft 365(Outlook・Teamsなど)で、Microsoftの側の障害が続いています。パソコンやアカウントの不具合ではないので、Outlookの入れ直しやパスワードの変更はしないでください。急ぎの連絡は電話で。「再ログインしてください」といったメールのリンクは開かないでください。障害のあいだに送ったメールは、復旧のあとで相手に届いたかを確かめてください。
自社がDefender XDRやPurviewを契約しているか、管理センターを誰が見られるかが分からない会社も多い。その場合は、今日のうちに契約しているIT業者に、影響と、復旧のあとに確かめることを聞いておく。
ふだんから
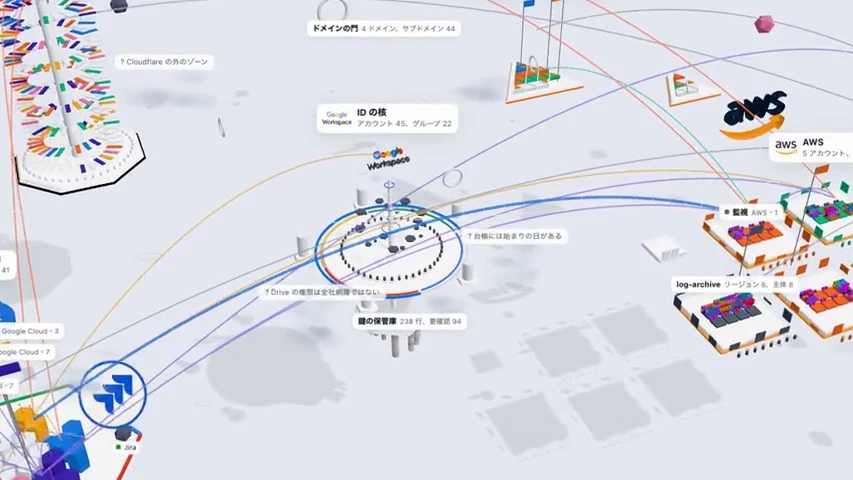
自社のどの仕事が、どの基盤に頼っているかを知っておく。下の図は、ある会社の例だ。
メールも会議もファイルも、見張りも情報漏えいの防止も、AIエージェントも、実は一つの基盤の上に乗っている。これを平時に一枚の地図にしておけば、止まった日に「何が止まり、何が動いていて、どの道で代わりをするか」を、すぐに決められる。
09最初の原因はまだ不明。Microsoftの次の発表は12時と12時30分
障害の広がり方はかなり見えてきたが、最初の引き金は分かっていない。今後のMicrosoftの発表で確かめたいのは、次の7つだ。
- 最初にサーバーを点検に落とし始めたのは、何だったのか
- 中核の処理があふれた、直接の理由は何か
- 最近の設定変更と、障害の始まりに関係はあったか
- 地域をまたいだ通信の振り分けや、共通の基盤が、障害を大きくしたか
- 攻撃を示す怪しい通信、権限の操作、侵入の跡は見つかったか
- Defender XDRやPurviewの見張りと情報の保護に、実際の抜けは出たか
- 全面的に復旧した時刻、影響を受けた会社の数、同じことを防ぐ手立ては何か
これらを確かめられる原因の報告は、まだ出ていない。【11時40分 更新】 Microsoftは次の更新を、Microsoft 365全体については日本時間の正午、Outlook(Exchange Online)については午後0時30分としている。新しい発表があれば、この記事を更新する。
この記事について
Microsoftが公開している障害の記録(ペンシルベニア大学が公開している写し)、Microsoft・OpenAI・Anthropicの稼働状況のページ、国内外の報道をもとに、Data is CITY Media 編集部がまとめました。情報は、2026年11月13日午前11時40分(日本時間)の時点のものです。障害は続いており、原因は確定していません。時刻はすべて日本時間に直しています(記録の写しの元の時刻は協定世界時)。Reuters・APの記事は、配信先の掲載で確かめました。過去の例は、各社の事後の報告と報道によります。
参考資料
- Microsoft 障害の記録(EX1550543・MO1550821・TM1550488・PP1550869。ペンシルベニア大学が公開している写し)https://mailservices.isc.upenn.edu/computing/email/penno365/alerts/ms-incidents.html
- Microsoft「Microsoft 365 の稼働状況」https://status.cloud.microsoft/
- Microsoft「Azure の状態」https://azure.status.microsoft/ja-jp/status
- OpenAI「Status」https://status.openai.com/incidents/01M78GAT3AK9P9W8Z230KHFVE8
- Anthropic「Claude Status」https://status.claude.com/
- 日本経済新聞(2026年11月13日)https://www.nikkei.com/article/DGXZQOGN12CY20S6A111C2000000/
- 朝日新聞(Yahoo!ニュースの掲載。2026年11月13日)https://news.yahoo.co.jp/articles/d2db8300ba543f40f0228994c065f5f28dbdb002
- ITmedia NEWS(2026年11月13日)https://www.itmedia.co.jp/news/article/2611/13/2000003161/
- Reuters(配信先の掲載。2026年11月12日)https://wtvbam.com/2026/11/12/microsoft-365-outlook-down-for-thousands-of-us-users-downdetector-shows/
- AP(配信先の掲載。2026年11月12日)https://www.news4jax.com/tech/2026/11/12/is-outlook-down-widespread-outage-hits-microsoft-email-and-other-apps/
- SecurityWeek https://www.securityweek.com/microsoft-365-outage-disrupts-outlook-exchange-online-and-teams/
- CP24(トロントの病院。2026年11月12日)https://www.cp24.com/local/toronto/2026/11/12/code-grey-declared-at-toronto-hospital-network-amid-microsoft-outage/
- ABC News(オーストラリア。2026年11月13日)https://www.abc.net.au/news/2026-11-13/microsoft-outage-affects-users-worldwide/107381050
- Google「Site Reliability Engineering:Addressing Cascading Failures」https://sre.google/sre-book/addressing-cascading-failures/
- AWS「Summary of the Amazon DynamoDB Service Disruption in the Northern Virginia (US-EAST-1) Region」(2025年10月)https://aws.amazon.com/message/101925/
- AWS Builders' Library「Implementing health checks」https://builder.aws.com/content/3Ev53O39izHCtWLzp4XU6t8PC1O/implementing-health-checks
- Microsoft「Azure の状態の履歴」(2026年9月29日の件)https://azure.status.microsoft/en-us/status/history/
- The Register(Microsoft 365の2026年1月の障害。2026年1月23日)https://www.theregister.com/2026/01/23/microsoft_365_outage/